Skip to Content
Find dismissed updates here
Edit My Preferences
AI モデルのその先へ ―― 真の競争優位はどこから生まれるのか

理化学研究所が語る
「AI-Ready なデータ」が次のイノベーションを決める理由

序文

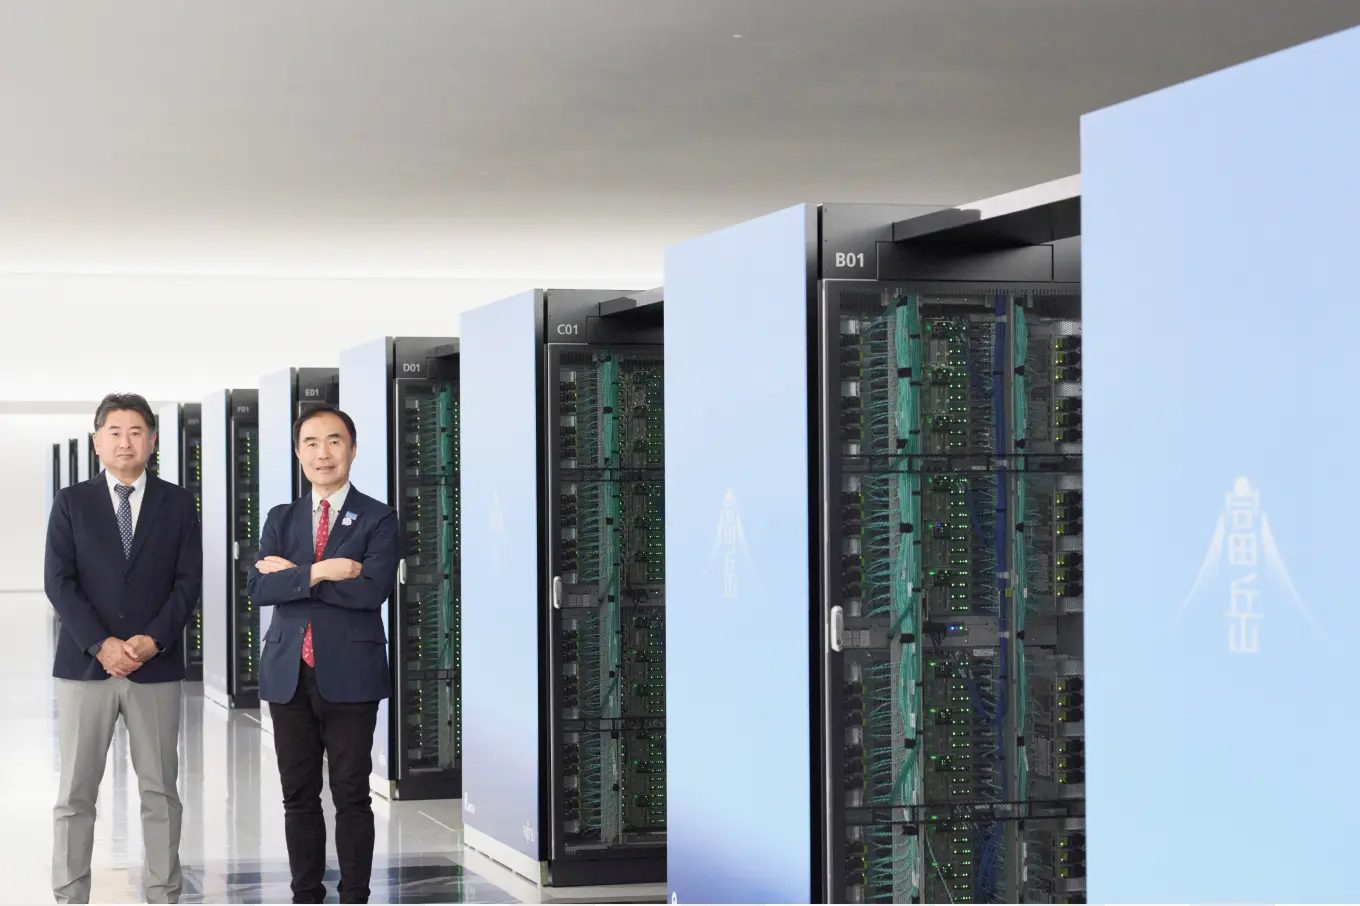
AI(人工知能)活用は企業活動のあらゆる領域へ広がりつつある。誰もが AI を活用する時代、競争力を左右するのは AI モデルそのものではない。AI が活用できるデータをどれだけ保有し、それを価値へ変換できるかが重要になり始めている。理化学研究所 計算科学研究センターはこうした変化を捉え、研究開発だけでなく、社会課題解決や産業イノベーションのための AI 活用に力を入れている。そのためにどのようなデータ基盤が必要なのか。スーパーコンピューター「富岳」を運用してきた同センター長の松岡 聡氏と、研究基盤の運用を担う同センター運用技術部門長の庄司 文由氏に話を聞いた。

「AI × スパコン」で 誰もがイノベーターになれる時代に

「AI × スパコン」で 誰もがイノベーターになれる時代に

生成 AI の進化によって、多くの企業で AI 活用が進んでいる。文章作成やプログラミング支援、情報検索などツールとしての利用にとどまらず、AI を軸に業務を再構築する動きも見られる。我が国が誇る、世界トップクラスの総合性能を有するスーパーコンピューター「富岳」にも、その波が迫りつつある。

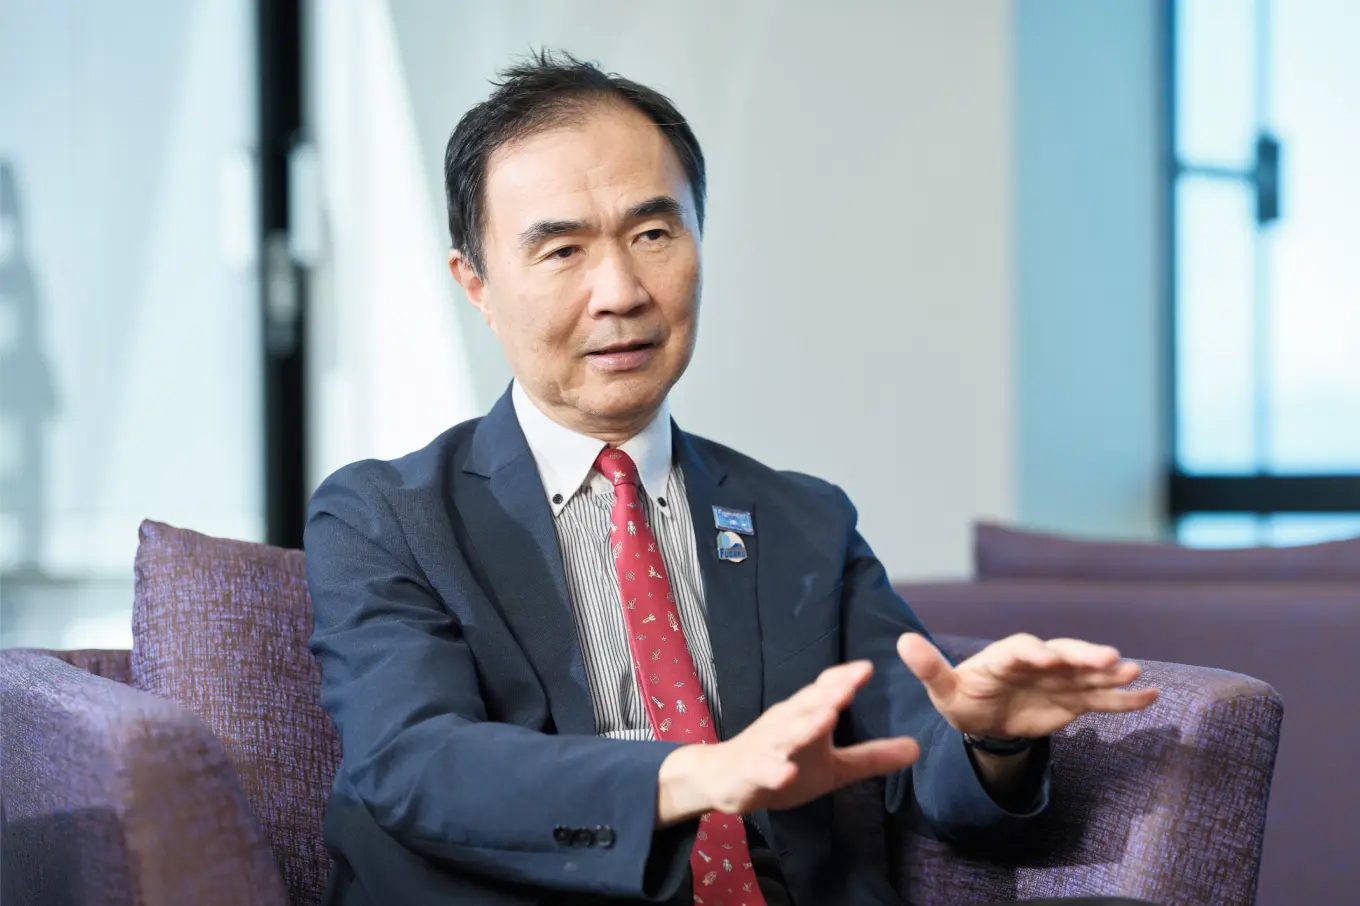
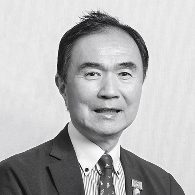
理化学研究所 計算科学研究センター(以下、R-CCS)が推進するのは「AI for Science and Industry Innovation」だ。「計算という技術を科学的に進化させていくとともに、それを産業や社会に展開し、社会課題の解決や産業イノベーションに貢献する。これが当センターの意義だと考えています」と R-CCS センター長の松岡 聡氏は強調する。

Actions
分(この記事を読む所要時間)

国立研究開発法人
理化学研究所 計算科学研究センター
センター長
松岡 聡氏

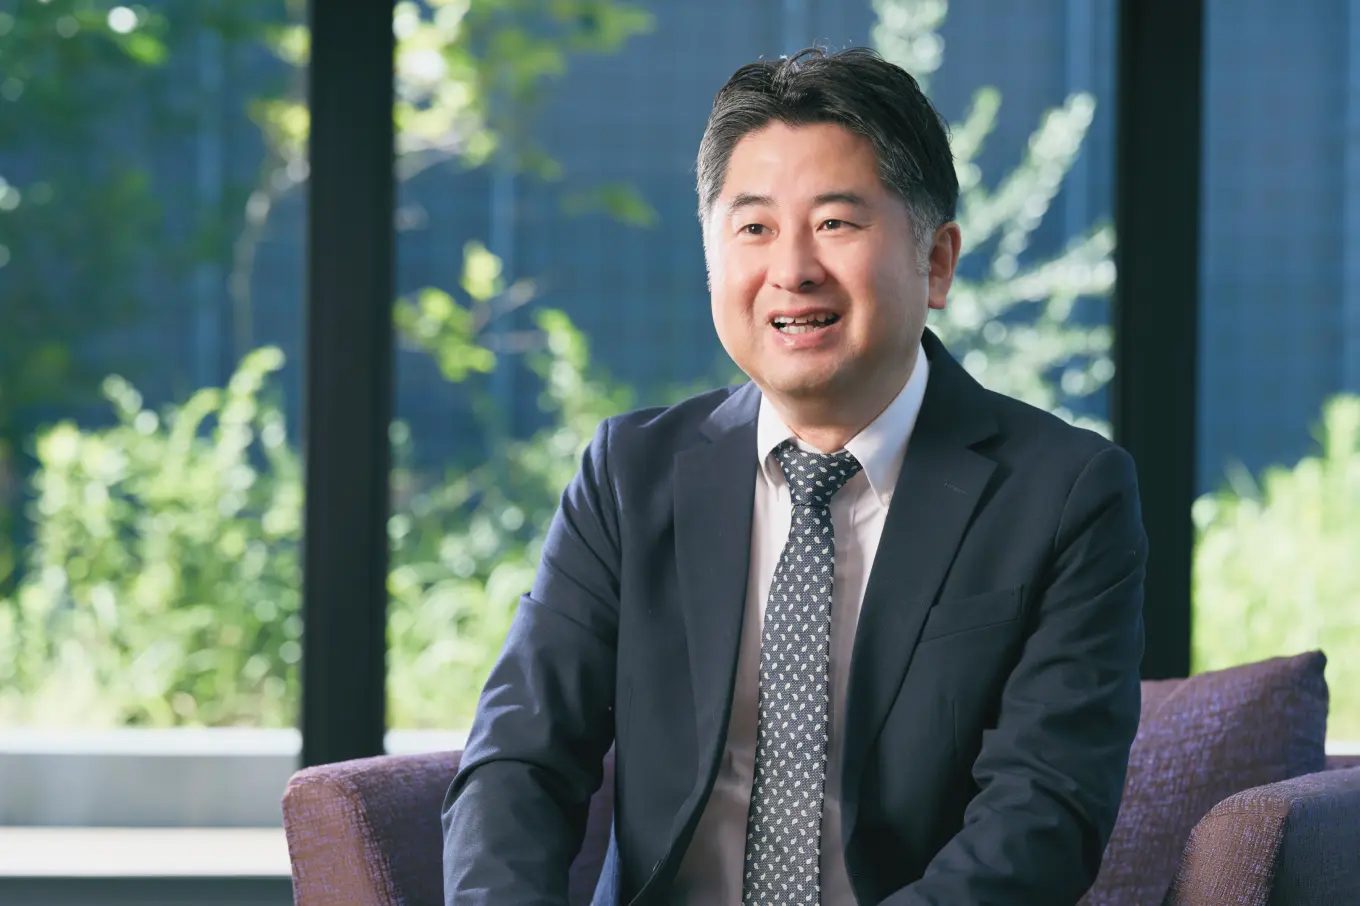
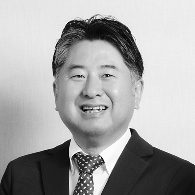
従来、スーパーコンピューターは限られた専門家が利用する “特別な計算資源” だったが、今後はそうではなくなっていく。それは AI エージェントを介して、スーパーコンピューターを利用できるようになるからだ。R-CCS センター運用技術部門長の庄司 文由氏は次のように語る。

「利用者が自然言語で問いを投げかけると、AI エージェントが必要なデータを探し出し、適切な計算環境を選択して、シミュレーションや解析を実行する。スーパーコンピューターは、人が直接使う存在から『AI に利用される存在』へと変わっていくでしょう」

Actions
分(この記事を読む所要時間)

国立研究開発法人
理化学研究所 計算科学研究センター
運用技術部門 部門長
庄司 文由氏

利用者はコマンドを駆使したり、スクリプトを書いたりする必要はない。漠然とした質問でも自然言語で AI に問いかければ、それを入り口にしてスーパーコンピューターが動く。その結果をどう解釈するかも AI が答えてくれる。

「スーパーコンピューターと無縁だった人でも最先端テクノロジーを利用できるようになるのです。裾野が広がり、イノベーションが次々起きるようになる。そんな世界が訪れるのではないかと今からワクワクしています」と庄司氏は続ける。

「富岳」をはじめとする大規模計算基盤は、AI による発見やイノベーションを支える社会基盤としての役割を担うようになるわけだ。

もちろん、その変化は計算基盤の使われ方だけでなく、研究開発そのものの進め方にも大きな影響を与える。創薬・材料開発・エネルギー・環境対策・ものづくりといった分野では、研究開発そのものが産業競争力の源泉になっている。AI はその研究開発プロセスも大きく変える。

「仮説の立案やデータ解析、知見の発見を AI が支援することで、一人ひとりのできることが格段に広がり、より大きな成果を生み出せるようになるでしょう。AI が研究者を置き換えるのではない。研究者や開発者の能力を何倍にも増幅することができるのです」と松岡氏は見る。

今のままでは「データ」がボトルネックになる

今のままでは「データ」がボトルネックになる

AI エージェントが研究開発に入り込む時代を見据え、R-CCS は新たな取り組みを進めている。その象徴が AI for Science 向けに開発したスーパーコンピューター「理究(りきゅう)」である。

AI 活用というと、画像処理半導体(GPU)の数や計算性能が注目されがちだが、「理究」を運用する中で別の課題も見えてきたという。それが「データ」だ。

AI 活用が進むほど、データ量は増え続ける。どれだけ高性能な GPU を用意しても、必要なデータが見つからない、その意味や文脈が理解できない、再利用できないといった状態では AI は十分に機能しない。「運用を重ねる中で、計算性能をどんなに高めても、従来の仕組みでは、データがボトルネックになると気づかされました」と庄司氏は振り返る。

必要なデータがどこにあり、何を意味し、どのように利用できるのか。それが把握できなければ、どれだけ高性能な AI を導入しても十分な成果にはつながらない。重要なのは、データを AI が活用できる状態で維持できるかどうかだ。

研究現場や企業には膨大なデータが存在している。しかし、その多くは AI がそのまま活用できる状態ではない。庄司氏が重視するのはデータの「セマンティクス」だ。「そのデータが何を表しているのか、どのような条件で生成されたのか、どの業務や研究と関係しているのかといった文脈まで理解する。セマンティクスとは、まさにその文脈情報のことです」と庄司氏は語る。

データは保存されているだけでは価値にならない。必要な時に見つけ出すことができ、その意味や背景を理解でき、さらに再利用できる状態になって初めて、AI 活用を支える“資産”として機能する。「AI が扱いやすいよう整理され、意味付けされ、継続的に活用できる『AI-Ready なデータ』が必要です」と庄司氏は主張する。

Actions
分(この記事を読む所要時間)

データを保存する時代から「活用し続ける」時代へ

データを保存する時代から「活用し続ける」時代へ

AI の進展・普及とともに、データを保存・管理するために欠かせないストレージの役割も変わりつつある。研究データも企業データも、生成された瞬間に価値が決まるわけではない。蓄積され、解析され、他の研究や開発に再利用されることで初めて、新たな価値を生み出す。AI 活用が本格化するほど、この循環をいかに効率よく回せるかが重要になる。

加えて、外部に公開できない秘匿データや機微情報を扱うシーンも多くなる。「データの保護だけでなく、その使い方を含めてセキュリティーとガバナンスを確保する必要がある」(庄司氏)。

社会課題を解決し、新しい産業を生み出して、研究開発を加速する。そのためには必要な時に必要なデータを見つけ出し、その意味を理解して、AI が利用しやすい “AI-Readyな形” で “安全に” 提供し続ける仕組みが必要になる。

データ基盤としてのストレージに求められる役割は「保存」から「活用」、そして「継続的な価値創出」へと変わりつつあるのだ。

「富岳」の後継機となる「富岳NEXT」(※開発コードネーム)の開発にも、こうしたデータ設計思想が盛り込まれている。「富岳」の開発・運用による経験・教訓を踏まえ、「富岳NEXT」は「Made with Japan」「技術革新」「持続性/継続性」という開発方針を掲げる。目指すのは “AIとの協働前提” のスーパーコンピューターだ。

「『富岳NEXT』は学術・研究機関だけでなく、民間企業にも広く開放していく計画です。このプラットフォームを軸に国際的な協力体制を構築できれば、研究開発や産業イノベーションが大きく加速し、その価値も増幅するでしょう。日本復活の起爆剤になると期待しています」と松岡氏は力を込める。

計算資源の重要性は今後も変わらない。しかし、競争力の源泉は計算能力そのものから「データを価値へ変換する力」へと移りつつある。AI 時代の競争力を決めるのは、どれだけ多くのデータを保有しているかではない。そのデータを AI が理解し、活用できる状態へ変換し続けられるかどうかが、継続的なイノベーションを生み出す鍵になるのである。

松岡 聡(まつおか さとし) 1963年東京都生まれ。東京大学大学院理学系研究科情報科学専攻修士課程修了、1993年理学博士。2018年から現職、東京科学大学特定教授(兼職)。専門は高性能計算機システム。2011、21年 ACM Gordon Bell Prize、2014年 Sidney Fernbach Award を日本人初受賞、2022年紫綬褒章、スーパーコンピューター分野の最高峰業績賞 Seymour Cray Computer Engineering Award、The Public Service Medal(シンガポール)ほか多数受賞。主な著書に『スパコン「富岳」の挑戦  GAFA なき日本の戦い方』(文春新書、2022年)がある。

庄司 文由(しょうじ ふみよし) 1970年山形県生まれ。2000年理学博士(金沢大学大学院)2005年から理化学研究所、2014年から現職。専門は大規模高性能計算機システムの効率的運用。スーパーコンピューター「京」及び「富岳」の開発・運用に従事。2011年 ACM Gordon Bell Prize、2013年電子情報通信学会業績賞。近年は次世代計算基盤の開発や、エネルギー効率やカーボン排出に配慮した持続可能なデータセンター運用、AI を活用した計算サービスの開発など、先端計算環境の整備と高度化を推進している。

AI-Ready なデータをどう実現するか

今回の取材を通じて浮かび上がったのは「AI-Ready なデータ」が競争力になるという点だ。しかし、実際には多くの企業や研究機関でデータは散在している。必要なデータがどこに存在するのか、何が保存されているのかも分からず、AI が利用できる状態になっていない――。こうした状況は決して珍しくない。

この課題に対して  Everpure が打ち出したのは、「Everpure Data Intelligence」と「Everpure Data Stream」の 2 つのアプローチである。Everpure Data Intelligence は企業や研究機関に散在するデータを発見・分類し、その内容や関係性を把握できるようにする。さらにコンテキスト(文脈情報)やナレッジグラフを活用することで、AI が理解しやすい形でデータを整理する。

一方の Everpure Data Stream は非構造化データを AI 活用に適したベクトル形式へ変換し、AI モデルへの提供までを一連の流れとして実装する。単にデータを保存するのではなく、AI が活用できる状態へと継続的に変換する仕組みであり、組織がより早く成果につなげることを可能にする。

AI for Science を推進する中で R-CCS が直面した「AI-Ready なデータ」「セマンティクス」「データの継続的活用」という課題は、まさに次世代データ基盤が向き合う中核テーマである。AI 時代の競争力を左右するのは AI モデルそのものではなく、データを理解し、価値へ変換して、活用し続ける仕組みを持てるかどうかだ。そうした仕組みは、これからの企業や研究機関にとって重要な競争基盤になっていくだろう。

※ 本記事のオリジナルは日経電子版に掲載されたものです。

展示会
2026年10月6日|ANA インターコンチネンタルホテル東京

Pure Accelerate Tokyo

Pure Accelerate 2026 が 2026年10月6日(火)に東京で開催されます。AI 時代に求められる次世代データ主権をテーマに、充実した内容をお届けします。ご登録をお待ちしております!
このブラウザは現在サポートされていません。

古いブラウザには、セキュリティ・リスクが存在する場合があります。ピュア・ストレージの Web サイトをより快適にご利用いただけるよう、最新のブラウザにアップデートしてください。

Personalize for Me
Steps Complete!
1
2
3
Continue where you left off
Personalize your Everpure experience
Select a challenge, or skip and build your own use case.
ニーズの変化に対応する仮想化戦略

あらゆるニーズに応えるストレージの選択肢

あらゆる規模の AI を支援

データ・パイプライン、トレーニング、推論に最適な高性能ストレージ

データ損失からの保護

サイバー・レジリエンス・ソリューションがデータを保護

クラウド運用コストを削減

Azure、AWS、プライベート・クラウドを支える高コスト効率のストレージ

アプリとデータベースを高速化

アプリケーションの性能を高める低レイテンシ―のストレージ

省電力・省スペースのデータセンターを実現

リソース消費効率の高いストレージが、データセンターを高効率化

Confirm your outcome priorities
Your scenario prioritizes the selected outcomes. You can modify or choose next to confirm.
Primary
Reduce My Storage Costs
Lower hardware and operational spend.
Primary
Strengthen Cyber Resilience
Detect, protect against, and recover from ransomware.
Primary
Simplify Governance and Compliance
Easy-to-use policy rules, settings, and templates.
Primary
Deliver Workflow Automation
Eliminate error-prone manual tasks.
Primary
Use Less Power and Space
Smaller footprint, lower power consumption.
Primary
Boost Performance and Scale
Predictability and low latency at any size.
What’s your role and industry?
We've inferred your role based on your scenario. Modify or confirm and select your industry.
Select your industry
Financial services
Government
Healthcare
Education
Telecommunications
Automotive
Hyperscaler
Electronic design automation
Retail
Service provider
Transportation
Which team are you on?
Technical leadership team
Defines the strategy and the decision making process
Infrastructure and Ops team
Manages IT infrastructure operations and the technical evaluations
Business leadership team
Responsible for achieving business outcomes
Security team
Owns the policies for security, incident management, and recovery
Application team
Owns the business applications and application SLAs
Describe your ideal environment
Tell us about your infrastructure and workload needs. We chose a few based on your scenario.
Select your preferred deployment
Hosted
Dedicated off-prem
On-prem
Your data center + edge
Public cloud
Public cloud only
Hybrid
Mix of on-prem and cloud
Select the workloads you need
Databases
Oracle, SQL Server, SAP HANA, open-source

Key benefits:

  • Instant, space-efficient snapshots

  • Near-zero-RPO protection and rapid restore

  • Consistent, low-latency performance


AI/ML and analytics
Training, inference, data lakes, HPC

Key benefits:

  • Predictable throughput for faster training and ingest

  • One data layer for pipelines from ingest to serve

  • Optimized GPU utilization and scale
Data protection and recovery
Backups, disaster recovery, and ransomware-safe restore

Key benefits:

  • Immutable snapshots and isolated recovery points

  • Clean, rapid restore with SafeMode™

  • Detection and policy-driven response


Containers and Kubernetes
Kubernetes, containers, microservices

Key benefits:

  • Reliable, persistent volumes for stateful apps

  • Fast, space-efficient clones for CI/CD

  • Multi-cloud portability and consistent ops
Cloud
AWS, Azure

Key benefits:

  • Consistent data services across clouds

  • Simple mobility for apps and datasets

  • Flexible, pay-as-you-use economics


Virtualization
VMs, vSphere, VCF, vSAN replacement

Key benefits:

  • Higher VM density with predictable latency

  • Non-disruptive, always-on upgrades

  • Fast ransomware recovery with SafeMode™


Data storage
Block, file, and object

Key benefits:

  • Consolidate workloads on one platform

  • Unified services, policy, and governance

  • Eliminate silos and redundant copies


What other vendors are you considering or using?
Thinking...
Your personalized, guided path
Get started with resources based on your selections.
My Updates
No updates at this time.